


Sztuczna inteligencja w analizie wydźwięku wielojęzycznej Wikipedii: klasyfikatory kontra duże modele językowe
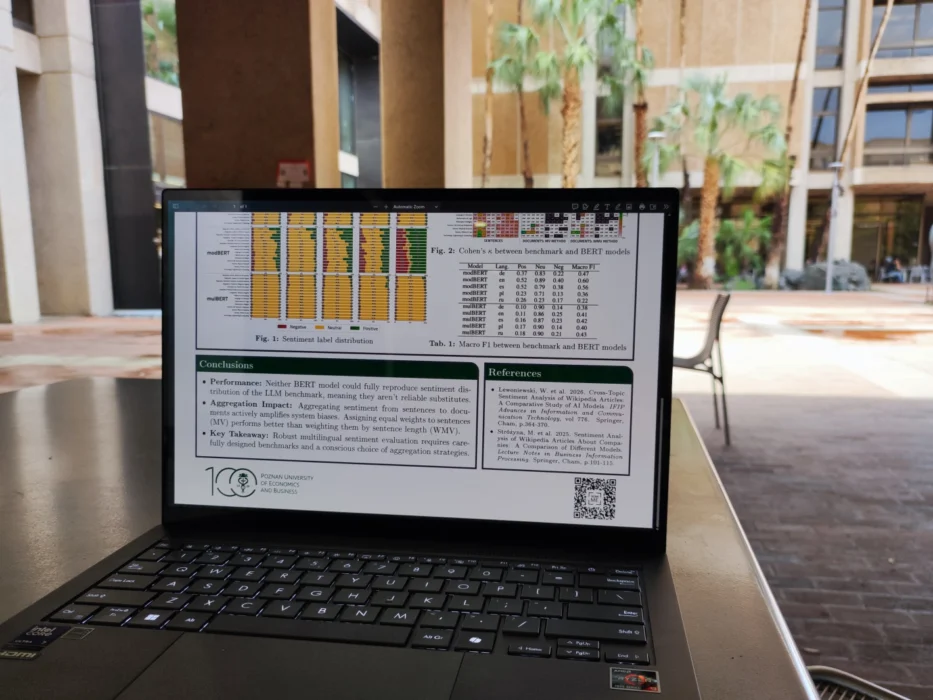
W przypadku Wikipedii analiza wydźwięku jest szczególnie interesującym zadaniem. Artykuły encyklopedyczne powinny być tworzone zgodnie z zasadą neutralnego punktu widzenia (NPOV), dlatego sygnały wskazujące na pozytywne lub negatywne nacechowanie bywają znacznie subtelniejsze niż np. w recenzjach produktów czy wpisach w mediach społecznościowych.
Nasi naukowcy przeanalizowali teksty Wikipedii w pięciu wersjach językowych: angielskiej, niemieckiej, hiszpańskiej, polskiej i rosyjskiej. Do adnotacji wykorzystano trzy duże modele językowe: GPT-5.2, Gemini 3.1 Pro, Claude Opus 4.6. Każdy z modeli oceniał poszczególne zdania trzykrotnie, co pozwoliło zbadać zarówno różnice pomiędzy modelami, jak i stabilność odpowiedzi tego samego modelu. Uzyskane wyniki porównano następnie z dwoma wielojęzycznymi klasyfikatorami wydźwięku opartymi na architekturze BERT.
Na podstawie ocen modeli utworzono wielojęzyczny benchmark do analizy wydźwięku tekstów Wikipedii. Do zbioru referencyjnego włączono te zdania, dla których wszystkie trzy duże modele językowe uzyskały zgodny wynik we wszystkich dziewięciu przebiegach. Tak restrykcyjne kryterium miało zwiększyć wiarygodność etykiet używanych później do oceny innych modeli.
Istotnym rezultatem badań jest również publiczne udostępnienie danych badawczych na platformie Kaggle. Zbiór obejmuje dane wykorzystane do budowy benchmarku oraz wyniki analizy wydźwięku dla pięciu wersji językowych Wikipedii. Udostępniono w nim m.in. etykiety pochodzące z benchmarku i badanych modeli, a także wyniki dla dwóch sposobów agregowania ocen pojedynczych zdań do poziomu całego artykułu. Dzięki temu dane mogą być ponownie wykorzystywane m.in. do porównywania kolejnych modeli analizy wydźwięku, badania różnic międzyjęzykowych oraz prowadzenia dalszych eksperymentów nad oceną neutralności tekstów encyklopedycznych.
Wyniki pokazują, że ocena wydźwięku tekstu może istotnie różnić się w zależności od zastosowanego modelu i języka. Autorzy zwracają także uwagę, że wydźwięk w tekstach encyklopedycznych jest często niejednoznaczny i silnie zależny od kontekstu, co sprawia, że jego automatyczne rozpoznawanie pozostaje wymagającym problemem badawczym w wielojęzycznym przetwarzaniu języka naturalnego.
Autorami pracy są pracownicy Katedry Informatyki Ekonomicznej: dr Milena Stróżyna, dr Włodzimierz Lewoniewski, mgr Izabela Czumałowska. Pełna treść publikacji jest dostępna na stronie ACL Anthology. DOI: 10.18653/v1/2026.gem-main.63